备选标题:
- 做LLM SEO踩过的三个没人说的坑
- 大模型时代,站长该怎么调整SEO方向
- LLM SEO真的能抢原本的搜索流量吗?
- 我停更三个月后靠LLM规则捡回流量的经历
- 普通人做LLM SEO的真实误区
本文选用标题:做LLM SEO踩过的三个没人说的坑
大家都在吹的「答案前置」其实是坑
刚接触这个玩法的时候,我跟大部分人一样,跟风把所有旧文都改成开头直接放答案。LLM要直接给结论,不然不会抓取你的内容——这句话刷到过十次以上吧?我信了。改完一个月,后台看大模型搜索来的流量,掉了快三成。
后来蹲了半个月大模型搜索的结果,慢慢摸出点门道。用户问大模型的问题,十有八九是带场景的,不是上来就要干结论。你上来就把所有结论甩出来,没有前因没有场景,大模型匹配的时候,反而找不到你的内容和用户问题的关联。
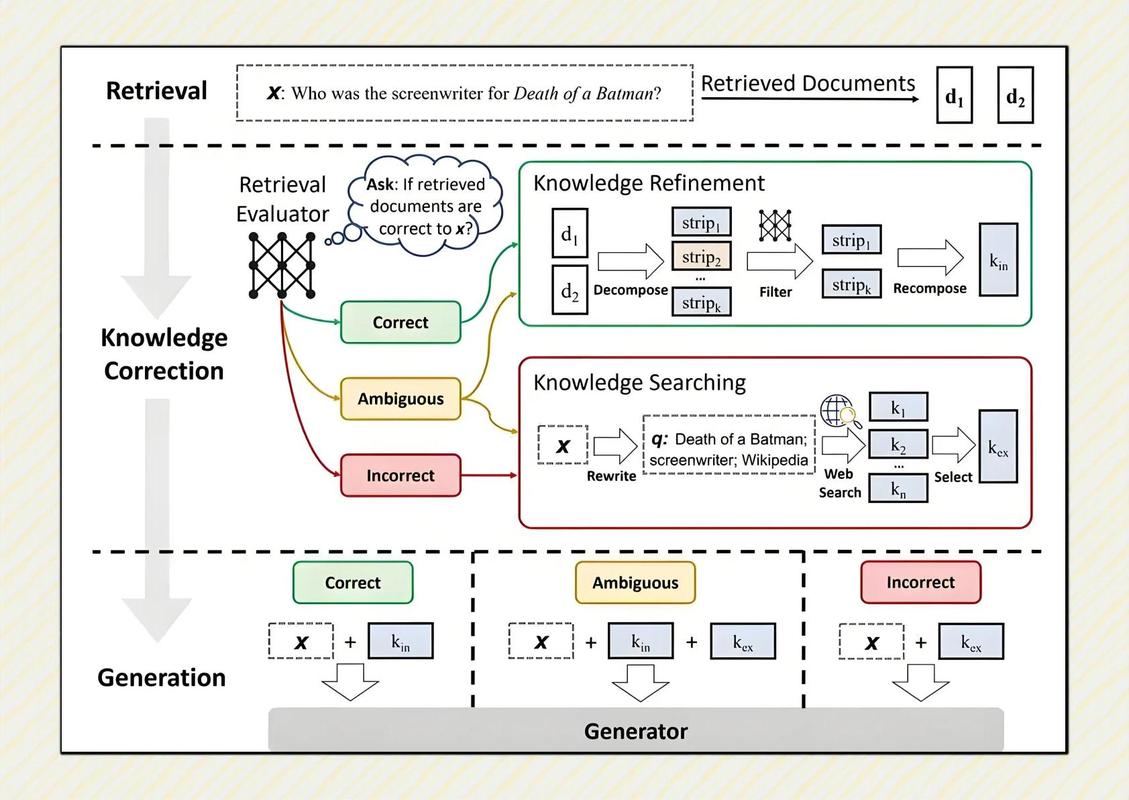
我后来把改了的文又改回去,把用户的常见问题场景放在开头,结论放在场景铺完之后,不到半个月,流量就慢慢回来了。
域名权重没你想的那么重要
做传统搜索久了,脑子就固定了——权重高的站靠前,权威站才会被收录。放到LLM SEO这里,这套逻辑不对。
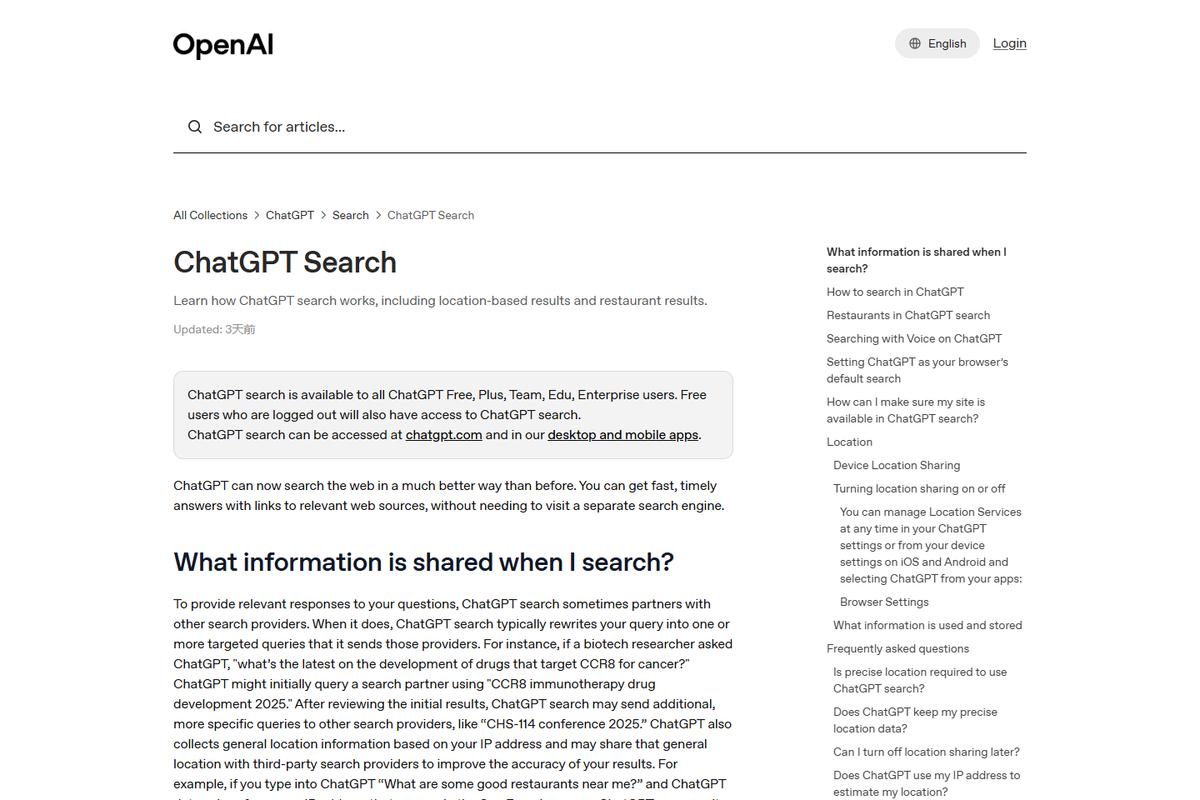
我翻过上百次ChatGPT、Perplexity的搜索结果,统计下来,快一半的引用来源,是建站不满两年的中小站,甚至还有不少是个人博客、独立站,域名权重连1都不到。
为什么?大模型找引用,找的是匹配用户问题的独特信息,不是找站点的资历。你一个做了十年的行业门户,内容全是网上抄来的通用话术,大模型训练的时候早就见过一万次了,根本不会优先选你。反过来,你一个新站,写了你自己实操踩过的具体坑,全网独一份,刚好用户问的就是这个坑,你就被选中了。
不过话说回来,也不是说权重完全没用。只是权重不再是硬性门槛了,中小站有了超车的机会,对吧?
堆关键词密度直接会被过滤
老SEO的毛病改不了,写东西总忍不住堆关键词,我也一样。一开始做的时候,特意把核心词密度从1%提到3%,想着这样LLM更容易识别内容主题。
结果呢?改完的二十多篇文章,两周过去,没有一篇被大模型搜索引用过。我当时一脸懵,不知道哪里错了。后来翻了几个大模型公开的搜索排序规则,哦——重复度太高的关键词,会直接被判定成SEO垃圾内容,踢出候选池。
现在我写内容,核心词能不说就不说,只在自然提到的地方出现一次,顶多两次。反而最近三个月,内容被引用的概率涨了两倍多。
上个月帮一个做户外装备的朋友调博客,就改了三点:把所有开头的总结删掉换成真实使用场景,删掉所有重复堆的关键词,每篇加一句只有他用过才会说的个人判断。改完不到二十天,大模型搜索过来的流量翻了四倍。
说实话,我现在看网上很多讲LLM SEO的,都是把传统SEO换个皮接着割韭菜。什么三天引流过万,什么全新蓝海,听听就得了。
本质上,这个玩法就是把评选标准从「站点资历」换成了「内容是不是真的解决问题」。你本来就有自己的真实体验,做垂直领域,这就是你的机会。不用跟老站拼资历拼权重,只要你的内容是独一份,能解决具体问题,就能拿到流量。
要是你本来就想着抄内容走捷径,那这套玩法不适合你。大模型比传统搜索引擎聪明多了,一眼就能认出哪些是抄的垃圾内容。
我踩过的坑,你能绕一个是一个。就这样。